08.12.2010

Quick & Dirty - JPA Native Queries und die Ergebnismenge

Ein Problem beim Absetzen von nativen Queries ist die unkomplizierte komplizierte Verarbeitung der Ergebnisse. Anstatt durch ein Array von Objekten zu iterieren wäre es ja durchaus wünschenswert, wenn man die Ergebnisse der Query direkt in eine zugehörige Bean transportieren kann.
Leider ist mit der Annotation @SqlResultSetMapping nur ein Mappen von Entitäten möglich, aber nicht von einfachen Beans, die für einen Datenaustausch oder eine Visualisierung innerhalb der GUI benötigt werden.

Um diesem Problem aus dem Weg zu gehen, habe ich einen kleinen Mapper erstellt, der es ermöglicht aus einer Liste, welche die Ergebnisse der Query in Arrays von Objekten enthält, eine Liste der gewünschten Beans erzeugt.


  1. An dieser Stelle werden die entsprechenden Klassen der Objekte ausgelesen und in ein Array gesteckt. Dies ist notwendig, damit man im zweiten Schritt mit Hilfe der Java Reflection API nach einem zugehörigen Konstruktor schauen kann.
  2. Suche nach dem Konstruktor mit der zugehörigen Signatur, die durch die Liste der Spalten innerhalb der Ergebnismenge definiert ist.
  3. Erstellen der entsprechenden Beans und hinzufügen zur Liste der Ergebnisse.
Narrensicher ist die Art der Konvertierung nicht. Die Konvertierung basiert im wesentlichen auf der Annahme, dass die Arrays innerhalb des Result Set grundsätzlich gleich sind und keine null-Werte enthalten sind. Sollte also jemand Verbesserungen bzw. Anregungen haben, dann immer her damit.

Da dies nur funktioniert, wenn die Liste der Ergebnisse mehrere Spalten enthält, habe ich gleichtzeitig noch eine Methode erstellt, die den unwahrscheinlichen Fall abdeckt, dass eine einzelne Spalte in eine Bean gesteckt werden soll. Daher der Vollständigkeit halber auch diese Methode als Screenshot.

07.12.2010

Quick & Dirty - JPA SQL Result Set Mapping

Das Mappen von nativen SQL Ergebnisse ist immer dann nützlich, wenn komplexe Queries formuliert werden, die nur nativ gelöst werden können oder performanter sind. Die Ergebnisse liegen dann oft nicht direkt als Entity vor, sondern müssen mühsam auseinandergenommen werden.
Daher bietet JPA die Möglichkeit an ein Mapping für die Ergebnismenge zu definieren.

Das Mapping wird mit Hilfe der @SqlResultSetMapping Annotation definiert und direkt über der entsprechenden Entität angegeben. Dabei besteht die Annotation aus einem, innerhalb der PersistenceUnit eindeutigem, Namen und einer bzw. mehreren Mappingklassen, welche später die Ergebnisse der Query beinhalten. Alternativ kann auch eine Klasse direkt beim Erstellen der nativen Query angegeben werden.

Um das Ganze besser zu verstehen und ein wenig mit den Möglichkeiten herumzuspielen werde ich an dieser Stelle ein paar Beispiele exerzieren.

Der Aufbau des Beispielprojektes entspricht im Wesentlichen dem wie in dem vorangegangenen Quick & Dirty bereits beschriebenen Aufbau. Daher werde ich darauf nicht weiter eingehen. Einzig und allein die Testklasse wird geändert, da der JUnit-Test nun andere Aufgaben erfüllen soll.

Einfachstes Beispiel ist das Auslesen einer kompletten Entität aus der Datenbank. Um das Anlegen wiederholbar zu gestalten und nicht redundant in jedem Test durchzuführen, wird eine entsprechende Methode definiert, welches dies für uns übernimmt.


Da die Entität im weiteren Verlauf nur gelesen werden soll, reicht es, wenn diese einmalig vor Ausführung des Tests angelegt wird. Vorher wird die Tabelle komplett geleert, so dass sich keine Altdaten in der Tabelle befinden.

Um später das Result Set Mapping zu nutzen wird die Klasse Employee noch mit der zugehörigen Annotation versehen. An dieser Stelle der einfachste Fall zuerst. Die Daten werden komplett in die entsprechende Entität geschrieben.


Damit kann nun innerhalb des Tests das Ergebnis der nativen SQL Abfrage direkt in die Entität geschrieben werden. Dabei muss nur auf den Namen des vorher definierten @SqlResultSetMapping verwiesen werden.


Das ist der einfachste Fall des Mappings.

06.12.2010

Quick & Dirty - JPA Constructor Expressions

JPA Constructor Expressions sind immer dann nützlich, wenn fein-granulare Objekte zum Austausch von Daten erzeugt werden sollen. Anstatt die Daten per Hand zusammenzustellen oder einen Assembler wie den GEDA DTO Assembler zu nutzen, können die Daten direkt in entsprechenden Objekte transferiert werden. Dabei hilft ein Hilfskonstruktor der JPA, die sogenannten Constructor Expressions.

Um diese einfach zu verstehen, an dieser Stelle ein kleines Tutorial zum Verständnis.

Wie immer muss die Basis für das Projekt geschaffen werden. Die Grundlage für das Tutorial bildet:

  1. Eclipse
  2. EclipseLink 2.10 (Helios) als JPA 2.0 Implementierung
  3. JUnit4
  4. HSQLDB als Datenbank
Das Projekt-Setup wird weitesgehend von Eclipse übernommen und soll an dieser Stelle nicht weiter vertieft werden.
Begonnen wird mit dem Einrichten des Workspaces. Dazu wird ein Projektordner erstellt und in diesen die entpackte Datenbank kopiert. Dies ist für den weiteren Verlauf des Einrichtens wichtig.


In diesem Ordner befinden sich sowohl die Datenbank, als auch die notwendigen Treiber.
Im zweiten Schritt wird ein JPA Projekt mit Eclipse angelegt.


Die Voreinstellungen können komplett übernommen werden. Nur der Name muss angegeben werden.


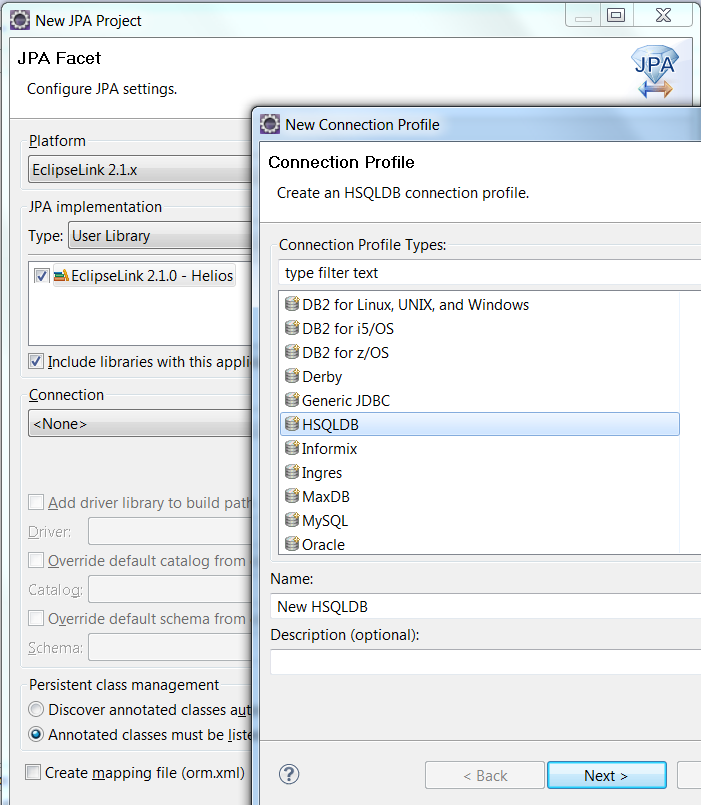
Im nächsten Schritt wird die Verbindung zur Datenbank und die eigentliche JPA Implementierung konfiguriert. Da es ein Quick & Dirty Tutorial ist, wird hier auf eine herunterladbare Bibliothek als JPA Implementierung verwiesen.


Im folgenden Schritt wird ein neues Connection-Profile angelegt. Hier wird die Verbindung zur HSQLDB festgelegt.


Als Treiber wird der vorher in den Projektordner kopierte Treiber gewählt.


Die Verbindungsdetails können aus den Defaulteinstellungen übernommen werden.


Somit sollte einer erfolgreichen Verbindung nichts im Wege stehen.


Nach dem Erstellen des Projektes müssen sowohl der Treiber, als auch die JUnit4 Bibliotheken dem Projekt hinzugefügt werden, so dass sich der folgende Aufbau ergibt.


Um später ohne Probleme eine Verbindung mit der Datenbank einzugehen, müssen die Eigenschaften der peristence.xml geringfügig modifiziert werden.

Die Einstellunge sorgen dafür, dass zum einen die Details für die Verbindung bekannt sind und zum anderen die Tabellen vor jedem Test wieder neu aufgesetzt werden.
Die Struktur der Klassen wird für den Test bewusst einfach gehalten:
  1. Employee [Entität innerhalb der Datenbank]
  2. EmployeeFirstnameDto [Einfaches DTO für die Darstellung des Vornamens]
  3. EmployeeFullnameDto[Einfaches DTO für die Darstellung des gesamten Namens]
  4. ConstructorExpressionsTest [JUnit-Test für die Ausführung]
Die Entität muss nach Erstellen noch als zu mappende Klasse in der persistence.xml angeführt werden.


Der Testfall führt nun unterschiedliche Aufgaben durch. Als erstes wird ein EntityManager erstellt, welcher für den Aufbau der Transaktionen und die Datenbankinteraktion vorhanden sein muss.

 
Im zweiten Schritt wird initial ein Employee erzeugt und sichergestellt, dass dieser auch in der Datenbank gespeichert worden ist.


Nun kommt der wichtige und spannende Teil. Das direkte Erstellen der DTOs aus der JPA-Query. Das Ergebnis der Query entspricht dem Typen, der übergeben wird. Dabei muss der zu erstellende Typ weder gemappt sein, noch sonstwie mit der Datenbank verknüpft werden.
Einzig und allein muss der entsprechende Konstruktur mit den übergebenen Attributen vorhanden sein.


Zugehöriger Konstruktor:


Das funktioniert natürlich auch für multiple Parameter.


Die Assertions stellen an dieser Stelle sicher, dass es sich auch wirklich um die entsprechenden Objekte handelt und nicht heimlich, still und leise die eigentliche Entität ausgelesen wird.

Wie auf der Konsole zu erkennen ist, handelt es sich auch wirklich um die entsprechenden DTOs.


Nützlich, wenn man sich das hin und her mit dem Konvertieren sparen möchte.

05.12.2010

Absolute Nullnummer auf Rügen...

Tja, es sollte der erste Bodden-Ausflug werden und war direkt ein Reinfall erster Güte. Sonntags angekommen wurden wir direkt mit Temperaturen weit unter 0°C empfangen. Dazu hat der WINDFINDER für Schaprode auch noch Sturm vorhergesagt.

Am Montag machte sich schnell Ernüchterung breit und der erste Blick aus dem Fenster offenbarte waagerecht fliegenden Schnee und eisige Kälte. Folglich war keine Ausfahrt möglich und der Tag wurde mit Hartz4-TV und BBQ verbummelt.

Dienstag sah es zwar windtechnisch besser aus, aber die Kälte war immer noch enorm. Daher auch bei Windstärke 5-6 und 8°C und Null keine Ausfahrt...

Naja, und am Mittwoch war dann klar, dass wir bei Sturm für Mittwoch und Donnerstag nicht mehr bleiben wollen. Daher ging es nach drei Tagen auf Rügen wieder nach Hause.

Wenigstens brauche ich für das nächste Mal keine Köder und kein Zubehör mehr kaufen ;-)

Glücklicherweise sind wenigstens ein paar Bilder bei der Tour entstanden.


Musky Innovations - Neue Farben für die kommende Saison

Musky Innovations hat für die kommende Saison ein paar interessante neue Farben im Spektrum. Die Reihe der Regular Bull Dawgs und Magnum Bull Dawgs sind um ein paar interessante neue Farben erweitert worden.

Regular Bull Dawg


Pro Dawg


 Magnum Bull Dawg


Bezugsquelle ist Jochen von Pikeworld.de