Vom 22.04.2013 - 26.04.2013 fand die JAX in Mainz statt und ich war da. Insgesamt eine tolle Veranstaltung mit vielen guten und sehr guten Speakern. Interessante Aussteller und eine sehr gute Organisation haben das Event abgerundet.
Falls jemand Interesse hat meine Reviews der einzelnen Tage, ein paar Bilder oder ein paar Videos anzuschauen, dann möchte ich an dieser Stelle auf meine Blogeinträge bei der LMIS AG aufmerksam machen.
Posts mit dem Label Softwareentwicklung werden angezeigt. Alle Posts anzeigen
24.05.2013
05.02.2011
Scrum - Komplexität der Softwareentwicklung
Im Rahmen einer jeden Entwicklung wird eine Menge an Anweisungen erzeugt, welche es ermöglichen eine Mensch-Maschine oder Maschine-Maschine Kommunikation zu etablieren.
Der Anforderungsgrad einer entwickelten Software kann von simpel bis unvorstellbar komplex reichen und somit kann auch der Grad der erforderlichen Genauigkeit schwanken. Mit dem Zusammenspiel von komplexen Anforderungen mit hoher Genauigkeit kann der Grad der Komplexität schnell unermesslich groß werden.
Ken Schwaber führt als Einflussgrößen die Menschen, die gewählte Technologie und die Anforderungen an. Ich persönliche sehe aber auch noch die Zeit als kritische Einflussgröße. Zwar nicht unmittelbar, wenn man die reine Komplexität einer Anforderung misst, aber doch unmittelbar, da die Zeit immer Einfluss auf die Menschen und die gewählte Technologie hat.
Anforderungen sind in der Praxis meist nicht trivial. In den meisten Fällen bleiben die Anforderungen auch nicht konstant, sondern werden im Rahmen der Entwicklung modifiziert oder auch komplett überarbeitet. Die gestellten Anforderungen kommen in der Regel vom Kunden. Die Kunden sind aber nicht ausschließlich die Personen, die ein Interesse an dem Ergebnis des Projektes haben. Somit wird der Begriff Stakeholder eingeführt. Dieser Begriff kennzeichnet wortwörtlich die Interessengruppe, die das Projekt unter Beobachtung hat. Dabei handelt es sich um Investoren, Anwender oder auch einfach nur durch das Projekt betroffene Teilnehmer, wie technische Administratoren. Damit wird es umso schwieriger die Interessen aller Beteiligten unter einen Hut zu bringen.
In der Regel kommen in Softwareprojekten keine einfachen Technologien zum Einsatz. Ken Schwaber hat eine schöne Definition, was Software-Entwicklungsprojekte angeht.
Er bezeichnet diese als "Anwendung moderner, häufig unzuverlässiger Technologien zur Umsetzung geschäftlicher Aufgabenstellungen und Erzielung von Vorteilen gegenüber dem Wettbewerb". Ich finde, dass dies ganz gut passt.
Betrachtet man nun die Abhängigkeit der Technologien und Anforderungen von einander, wird schnell klar, dass diese den Komplexitätsgrad des Projektes maßgeblich beeinflussen. Je weiter die Anforderungen von der Vereinbarung abschweifen, desto komplexer wird das Projekt. Je weniger Gewissheit über die Technologie herrscht, desto komplexer wird das Projekt.
Neben der Dimension der Technologie und der Dimension der Anforderung kommt noch der Faktor der Menschen hinzu. Alle Teilnehmer eines Entwicklungsteams sind in ihren Skills verschiedenen und haben in der Regeln unterschiedliche Standpunkte, Meinungen und Ansichten, die auch noch von persönlichen Emotionen beeinflusst werden. Wird diese Dimension berücksichtigt, so steigt der gesamte Grad der Komplexität um ein Vielfaches.
Scrum versucht diese Komplexität mit den Methoden aus der empirischen Prozessteuerung zu relativieren.
Der Anforderungsgrad einer entwickelten Software kann von simpel bis unvorstellbar komplex reichen und somit kann auch der Grad der erforderlichen Genauigkeit schwanken. Mit dem Zusammenspiel von komplexen Anforderungen mit hoher Genauigkeit kann der Grad der Komplexität schnell unermesslich groß werden.
![]() | ||
| Einflussgrößen bzgl der Komplexität |
Anforderungen sind in der Praxis meist nicht trivial. In den meisten Fällen bleiben die Anforderungen auch nicht konstant, sondern werden im Rahmen der Entwicklung modifiziert oder auch komplett überarbeitet. Die gestellten Anforderungen kommen in der Regel vom Kunden. Die Kunden sind aber nicht ausschließlich die Personen, die ein Interesse an dem Ergebnis des Projektes haben. Somit wird der Begriff Stakeholder eingeführt. Dieser Begriff kennzeichnet wortwörtlich die Interessengruppe, die das Projekt unter Beobachtung hat. Dabei handelt es sich um Investoren, Anwender oder auch einfach nur durch das Projekt betroffene Teilnehmer, wie technische Administratoren. Damit wird es umso schwieriger die Interessen aller Beteiligten unter einen Hut zu bringen.
In der Regel kommen in Softwareprojekten keine einfachen Technologien zum Einsatz. Ken Schwaber hat eine schöne Definition, was Software-Entwicklungsprojekte angeht.
Er bezeichnet diese als "Anwendung moderner, häufig unzuverlässiger Technologien zur Umsetzung geschäftlicher Aufgabenstellungen und Erzielung von Vorteilen gegenüber dem Wettbewerb". Ich finde, dass dies ganz gut passt.
Betrachtet man nun die Abhängigkeit der Technologien und Anforderungen von einander, wird schnell klar, dass diese den Komplexitätsgrad des Projektes maßgeblich beeinflussen. Je weiter die Anforderungen von der Vereinbarung abschweifen, desto komplexer wird das Projekt. Je weniger Gewissheit über die Technologie herrscht, desto komplexer wird das Projekt.
Gewissheit bzgl. der Technologie | Abweichung von den Anforderungen | Komplexität des Projektes |
Neben der Dimension der Technologie und der Dimension der Anforderung kommt noch der Faktor der Menschen hinzu. Alle Teilnehmer eines Entwicklungsteams sind in ihren Skills verschiedenen und haben in der Regeln unterschiedliche Standpunkte, Meinungen und Ansichten, die auch noch von persönlichen Emotionen beeinflusst werden. Wird diese Dimension berücksichtigt, so steigt der gesamte Grad der Komplexität um ein Vielfaches.
Scrum versucht diese Komplexität mit den Methoden aus der empirischen Prozessteuerung zu relativieren.
10.12.2010
Quick & Dirty - JPA Native Queries und die Ergebnismenge 2
Die bereits vorgestellte Lösung für das Mappen nativer Ergebnismengen ist durchaus akzeptabel, wenn keine null-Werte innerhalb des Resultsets vorkommen.
Da das Vorkommen von null-Werten allerdings leider eher die Regel als eine wenig zu beachtende Ausnahme ist muss an der Realisierung noch etwas gefeilt werden.
Die Realisierung mit Hilfe des erstellten Arrays aus Klassen anhand der Objekte in der Ergebnismenge ist somit hinfällig und kann nicht mehr als Ausgangspunkt für eine Lösung dienen.
Die aktualisierte Fassung baut auf einer selbst definierten Annotation auf, welche über einem Konstruktor nach Wahl notiert wird. Dabei wird für die Annotation ein sprechender Mappingname vergeben, so dass auch mehrere dieser Annotation innerhalb einer Klasse vergeben werden können.
Der Ablaug des Mappings lässt sich im Groben wie folgt skizzieren:
Basis für das Mappen der Bean ist die entsprechende Annotation innerhalb der zu mappenden Bean. Dafür wird eine selbst definierte Annotation verwendet.
Für das Definieren der Annotation wir der Retention-Type Runtime verwendet, da die Annotationen auch zur Laufzeit noch vorhanden sein sollten. Die Annotation an sich soll nur über den entsprechenden Konstruktoren verwendet werden, so dass keine andere Nutzung gegeben ist. Dies bietet den Vorteil, dass in einem zweiten Schritt nur die Konstruktoren aus der zu mappenden Bean analysiert werden müssen. @Documented zeigt an, dass auch diese Klasse innerhalb des Javadocs erscheinen soll. Dies wäre ohne die Annotation nicht der Fall.
Die Klasse ResultSetMapper muss nun dahingehend verändert werden, dass die Menge an Konstructoren durchsucht wird und der gewünschte Konstruktor herausgestellt wird.
Im ersten Schritt werden die in der Klasse deklarierten Konstruktoren mittels Reflection ermittelt. Der zweite Schritt dient nun dem Ermitteln des gewünschten Konstruktors anhand der Annotation und dem spezifischen Namen des Mappings.
Im zweiten Teil der Methode muss nun die neue Instanz der Bean erzeugt werden. Dies lässt sich über den gefunden Konstruktor realisieren. Sollte kein Konstruktor gefunden worden sein, so wird eine entsprechende Exception (siehe 1) geworfen. Sollte bei dem Erstellen der Instanz eine falsche Parameteranzahl oder -reihenfolge angegeben worden sein, so wird eine ParameterMismatchException geworfen.
Damit ist nun auch ein Mappen von ResultSets möglich, die null-Werte enthalten.
07.12.2010
Quick & Dirty - JPA SQL Result Set Mapping
Das Mappen von nativen SQL Ergebnisse ist immer dann nützlich, wenn komplexe Queries formuliert werden, die nur nativ gelöst werden können oder performanter sind. Die Ergebnisse liegen dann oft nicht direkt als Entity vor, sondern müssen mühsam auseinandergenommen werden.
Daher bietet JPA die Möglichkeit an ein Mapping für die Ergebnismenge zu definieren.
Das Mapping wird mit Hilfe der @SqlResultSetMapping Annotation definiert und direkt über der entsprechenden Entität angegeben. Dabei besteht die Annotation aus einem, innerhalb der PersistenceUnit eindeutigem, Namen und einer bzw. mehreren Mappingklassen, welche später die Ergebnisse der Query beinhalten. Alternativ kann auch eine Klasse direkt beim Erstellen der nativen Query angegeben werden.
Um das Ganze besser zu verstehen und ein wenig mit den Möglichkeiten herumzuspielen werde ich an dieser Stelle ein paar Beispiele exerzieren.
Der Aufbau des Beispielprojektes entspricht im Wesentlichen dem wie in dem vorangegangenen Quick & Dirty bereits beschriebenen Aufbau. Daher werde ich darauf nicht weiter eingehen. Einzig und allein die Testklasse wird geändert, da der JUnit-Test nun andere Aufgaben erfüllen soll.
Einfachstes Beispiel ist das Auslesen einer kompletten Entität aus der Datenbank. Um das Anlegen wiederholbar zu gestalten und nicht redundant in jedem Test durchzuführen, wird eine entsprechende Methode definiert, welches dies für uns übernimmt.
Da die Entität im weiteren Verlauf nur gelesen werden soll, reicht es, wenn diese einmalig vor Ausführung des Tests angelegt wird. Vorher wird die Tabelle komplett geleert, so dass sich keine Altdaten in der Tabelle befinden.
Um später das Result Set Mapping zu nutzen wird die Klasse Employee noch mit der zugehörigen Annotation versehen. An dieser Stelle der einfachste Fall zuerst. Die Daten werden komplett in die entsprechende Entität geschrieben.
Damit kann nun innerhalb des Tests das Ergebnis der nativen SQL Abfrage direkt in die Entität geschrieben werden. Dabei muss nur auf den Namen des vorher definierten @SqlResultSetMapping verwiesen werden.
Das ist der einfachste Fall des Mappings.
Daher bietet JPA die Möglichkeit an ein Mapping für die Ergebnismenge zu definieren.
Das Mapping wird mit Hilfe der @SqlResultSetMapping Annotation definiert und direkt über der entsprechenden Entität angegeben. Dabei besteht die Annotation aus einem, innerhalb der PersistenceUnit eindeutigem, Namen und einer bzw. mehreren Mappingklassen, welche später die Ergebnisse der Query beinhalten. Alternativ kann auch eine Klasse direkt beim Erstellen der nativen Query angegeben werden.
Um das Ganze besser zu verstehen und ein wenig mit den Möglichkeiten herumzuspielen werde ich an dieser Stelle ein paar Beispiele exerzieren.
Der Aufbau des Beispielprojektes entspricht im Wesentlichen dem wie in dem vorangegangenen Quick & Dirty bereits beschriebenen Aufbau. Daher werde ich darauf nicht weiter eingehen. Einzig und allein die Testklasse wird geändert, da der JUnit-Test nun andere Aufgaben erfüllen soll.
Einfachstes Beispiel ist das Auslesen einer kompletten Entität aus der Datenbank. Um das Anlegen wiederholbar zu gestalten und nicht redundant in jedem Test durchzuführen, wird eine entsprechende Methode definiert, welches dies für uns übernimmt.
Um später das Result Set Mapping zu nutzen wird die Klasse Employee noch mit der zugehörigen Annotation versehen. An dieser Stelle der einfachste Fall zuerst. Die Daten werden komplett in die entsprechende Entität geschrieben.
Damit kann nun innerhalb des Tests das Ergebnis der nativen SQL Abfrage direkt in die Entität geschrieben werden. Dabei muss nur auf den Namen des vorher definierten @SqlResultSetMapping verwiesen werden.
Das ist der einfachste Fall des Mappings.
06.12.2010
Quick & Dirty - JPA Constructor Expressions
JPA Constructor Expressions sind immer dann nützlich, wenn fein-granulare Objekte zum Austausch von Daten erzeugt werden sollen. Anstatt die Daten per Hand zusammenzustellen oder einen Assembler wie den GEDA DTO Assembler zu nutzen, können die Daten direkt in entsprechenden Objekte transferiert werden. Dabei hilft ein Hilfskonstruktor der JPA, die sogenannten Constructor Expressions.
Um diese einfach zu verstehen, an dieser Stelle ein kleines Tutorial zum Verständnis.
Wie immer muss die Basis für das Projekt geschaffen werden. Die Grundlage für das Tutorial bildet:
Begonnen wird mit dem Einrichten des Workspaces. Dazu wird ein Projektordner erstellt und in diesen die entpackte Datenbank kopiert. Dies ist für den weiteren Verlauf des Einrichtens wichtig.
In diesem Ordner befinden sich sowohl die Datenbank, als auch die notwendigen Treiber.
Im zweiten Schritt wird ein JPA Projekt mit Eclipse angelegt.
Die Voreinstellungen können komplett übernommen werden. Nur der Name muss angegeben werden.
Im nächsten Schritt wird die Verbindung zur Datenbank und die eigentliche JPA Implementierung konfiguriert. Da es ein Quick & Dirty Tutorial ist, wird hier auf eine herunterladbare Bibliothek als JPA Implementierung verwiesen.
Als Treiber wird der vorher in den Projektordner kopierte Treiber gewählt.
Die Verbindungsdetails können aus den Defaulteinstellungen übernommen werden.
Somit sollte einer erfolgreichen Verbindung nichts im Wege stehen.
Nach dem Erstellen des Projektes müssen sowohl der Treiber, als auch die JUnit4 Bibliotheken dem Projekt hinzugefügt werden, so dass sich der folgende Aufbau ergibt.
Um später ohne Probleme eine Verbindung mit der Datenbank einzugehen, müssen die Eigenschaften der peristence.xml geringfügig modifiziert werden.
Die Einstellunge sorgen dafür, dass zum einen die Details für die Verbindung bekannt sind und zum anderen die Tabellen vor jedem Test wieder neu aufgesetzt werden.
Die Struktur der Klassen wird für den Test bewusst einfach gehalten:
Der Testfall führt nun unterschiedliche Aufgaben durch. Als erstes wird ein EntityManager erstellt, welcher für den Aufbau der Transaktionen und die Datenbankinteraktion vorhanden sein muss.
Im zweiten Schritt wird initial ein Employee erzeugt und sichergestellt, dass dieser auch in der Datenbank gespeichert worden ist.
Nun kommt der wichtige und spannende Teil. Das direkte Erstellen der DTOs aus der JPA-Query. Das Ergebnis der Query entspricht dem Typen, der übergeben wird. Dabei muss der zu erstellende Typ weder gemappt sein, noch sonstwie mit der Datenbank verknüpft werden.
Einzig und allein muss der entsprechende Konstruktur mit den übergebenen Attributen vorhanden sein.
Zugehöriger Konstruktor:
Das funktioniert natürlich auch für multiple Parameter.
Die Assertions stellen an dieser Stelle sicher, dass es sich auch wirklich um die entsprechenden Objekte handelt und nicht heimlich, still und leise die eigentliche Entität ausgelesen wird.
Wie auf der Konsole zu erkennen ist, handelt es sich auch wirklich um die entsprechenden DTOs.
Nützlich, wenn man sich das hin und her mit dem Konvertieren sparen möchte.
Um diese einfach zu verstehen, an dieser Stelle ein kleines Tutorial zum Verständnis.
Wie immer muss die Basis für das Projekt geschaffen werden. Die Grundlage für das Tutorial bildet:
- Eclipse
- EclipseLink 2.10 (Helios) als JPA 2.0 Implementierung
- JUnit4
- HSQLDB als Datenbank
Begonnen wird mit dem Einrichten des Workspaces. Dazu wird ein Projektordner erstellt und in diesen die entpackte Datenbank kopiert. Dies ist für den weiteren Verlauf des Einrichtens wichtig.
In diesem Ordner befinden sich sowohl die Datenbank, als auch die notwendigen Treiber.
Im zweiten Schritt wird ein JPA Projekt mit Eclipse angelegt.
Die Voreinstellungen können komplett übernommen werden. Nur der Name muss angegeben werden.
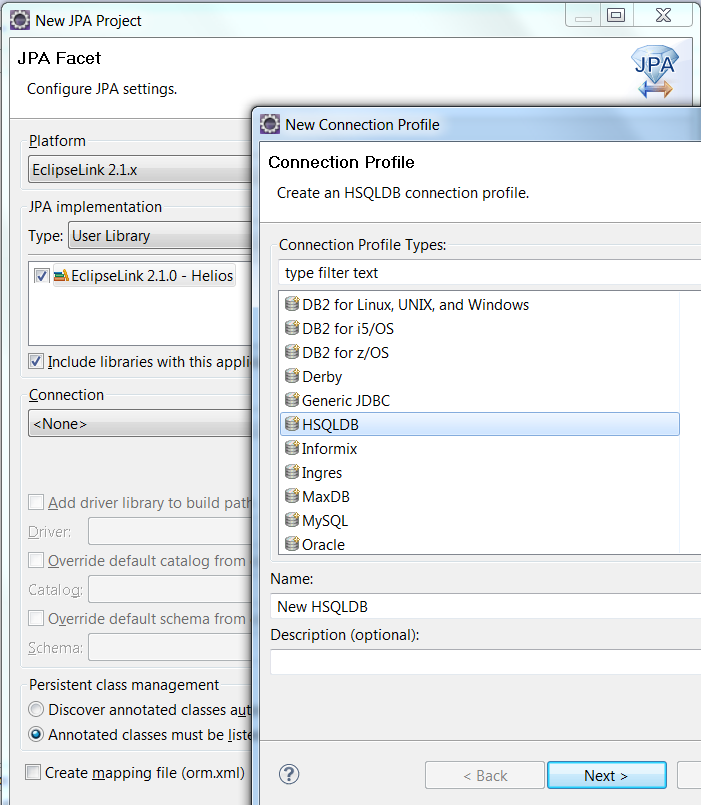
Im nächsten Schritt wird die Verbindung zur Datenbank und die eigentliche JPA Implementierung konfiguriert. Da es ein Quick & Dirty Tutorial ist, wird hier auf eine herunterladbare Bibliothek als JPA Implementierung verwiesen.
Im folgenden Schritt wird ein neues Connection-Profile angelegt. Hier wird die Verbindung zur HSQLDB festgelegt.
Die Verbindungsdetails können aus den Defaulteinstellungen übernommen werden.
Somit sollte einer erfolgreichen Verbindung nichts im Wege stehen.
Nach dem Erstellen des Projektes müssen sowohl der Treiber, als auch die JUnit4 Bibliotheken dem Projekt hinzugefügt werden, so dass sich der folgende Aufbau ergibt.
Um später ohne Probleme eine Verbindung mit der Datenbank einzugehen, müssen die Eigenschaften der peristence.xml geringfügig modifiziert werden.
Die Einstellunge sorgen dafür, dass zum einen die Details für die Verbindung bekannt sind und zum anderen die Tabellen vor jedem Test wieder neu aufgesetzt werden.
Die Struktur der Klassen wird für den Test bewusst einfach gehalten:
- Employee [Entität innerhalb der Datenbank]
- EmployeeFirstnameDto [Einfaches DTO für die Darstellung des Vornamens]
- EmployeeFullnameDto[Einfaches DTO für die Darstellung des gesamten Namens]
- ConstructorExpressionsTest [JUnit-Test für die Ausführung]
Der Testfall führt nun unterschiedliche Aufgaben durch. Als erstes wird ein EntityManager erstellt, welcher für den Aufbau der Transaktionen und die Datenbankinteraktion vorhanden sein muss.
Im zweiten Schritt wird initial ein Employee erzeugt und sichergestellt, dass dieser auch in der Datenbank gespeichert worden ist.
Nun kommt der wichtige und spannende Teil. Das direkte Erstellen der DTOs aus der JPA-Query. Das Ergebnis der Query entspricht dem Typen, der übergeben wird. Dabei muss der zu erstellende Typ weder gemappt sein, noch sonstwie mit der Datenbank verknüpft werden.
Einzig und allein muss der entsprechende Konstruktur mit den übergebenen Attributen vorhanden sein.
Zugehöriger Konstruktor:
Das funktioniert natürlich auch für multiple Parameter.
Die Assertions stellen an dieser Stelle sicher, dass es sich auch wirklich um die entsprechenden Objekte handelt und nicht heimlich, still und leise die eigentliche Entität ausgelesen wird.
Wie auf der Konsole zu erkennen ist, handelt es sich auch wirklich um die entsprechenden DTOs.
Nützlich, wenn man sich das hin und her mit dem Konvertieren sparen möchte.
15.11.2010
JUnit - Testing Framework für Komponententests
JUnit dient dem Entwickler als Framework für das Testen von geschriebenem Code. In den meisten Fällen wird JUnit als Framework für das Testen von einzelnen Modulen genutzt.
Das Testen von geschriebenem Code dient der Qualitätssicherung des gesamten Projektes. Dabei existieren unterschiedliche Metriken, wie viel und vor allem was in welchem Umfang getestet werden soll.
In der Regel sollten die Tests geschrieben werden bevor das eigentliche Modul entwickelt wird. Damit ist eine gründliche Auseinandersetzung mit den Anforderungen gegeben und der Entwickler gerät nicht in Versuchung nur den meist genutzten Pfad durch die Applikation zu testen.
Für das Beispiel wird ein Modul erstellt, welches eine kleine Benutzeranmeldung simuliert. Der Einfachheit halber werden die Daten im ersten Schritt nur lokal zur Verfügung stehen und werden mit Beenden des Programmes wieder gelöscht. Der Logout nach der Durchführung der unterschiedlichen Aktionen wird ebenfalls automatisiert durchgeführt.
Somit ergeben sich insgesamt 4 unterschiedliche Pfade, die getestet werden müssen.
Die aktuelle Bibliothek (zum Zeitpunkt dieses Artikels Versioon 4.8.2) kann über die JUnit Webseite bezogen werden. Diese wird unter Eclipse dem Projekt hinzugefügt und in den Classpath eingebunden
Für die Implementierung des Testfalls wird eine neue Klasse angelegt.
Die einzelnen Methoden testen die Funktionalität des UserMgr. Zusätzlich werden Methoden für Aufgaben vor jedem Test und nach jedem Test definiert.
Mit Hilfe der Annotationen kann der Test leicht konfiguriert werden. Die Annotation org.junit.Before definiert eine Methode, die vor jedem Test ausgeführt wird. Mit org.junit.After wird eine Methode definiert, die nach der Durchführung eines jeden Tests ausgeführt werden kann.
Zusätzlich könnte der Test noch mit den Annotationen org.junit.BeforeClass und org.junit.AfterClass erweitert werden. Diese Annotationen können an statischen Methoden definiert werden und erlauben es die Methoden als statische Methoden beim Laden der Klasse und als letzte Aktion nach Testende auszuführen.
Die einzelnen Methoden des Tests werden mit org.junit.Test gekennzeichnet. Diese Annotation kann sowohl auf Klassenebene, als auch auf Methodeneben genutzt werden. Wird die Methode auf Klassenebene genutzt, dann wird jede Methode als Testmethode angesehen. Auf Methodenebene kann deutlich detaillierter gesteuert werden, welche Methode als Testmethode genutzt wird.
Das Exceptionhandling kann ebenfalls getestet werden. Dafür kann der Annotation org.junit.Test ein weiteres Attribut in Form der erwarteten Exception mitgegeben werden. Der Test wird fehlschlagen, sobald diese Exception nicht auftritt und nur dann erfolgreich sein, wenn die Exception auftritt.
Um erstellten Code effizient zu testen, wird der Entwickler immer Wissen aus der Implementierung mit einbringen und sogenannte Whitebox-Tests durchführen. Daher ist es sinnvoll an dieser Stelle die Implementierung der Klasse durchzuführen. Diese wird für das Beispiel bewusst einfach gehalten.
Für die Verwaltung der Nutzer werden zwei private Variablen deklariert, welche nach außen hin nicht sichtbar sein sollen. Daher erfolgt der Zugriff nicht über Getter- / Setter-Methoden.
Die eigentliche Implementierung stellt nun die Möglichkeit bereit einen Nutzer in die Liste der registrierten Nutzer aufzunehmen, sich einzuloggen und die Liste der eingeloggten Nutzer auszulesen.
Nach der Implementierung des Grundgerüstes werden die Testmethoden konkret implementiert. Um die Testmethoden effizient und sinnvoll zu implementieren ist ein wenig Wissen über die eigentliche Implementierung notwendig. Die Daten über die angemeldeten und verfügbaren Nutzer werden intern in einer Map verwaltet. Der Einfachheit halber werden die Daten im Klartext abgelegt. Um sinnvoll testen zu können müssen aber vor einem Test bereits Daten in dieser Map vorhanden sein.
Diese Daten können auf unterschiedliche Wege in die Map eingefügt werden. Zum einen können die Funktionen des Managers genutzt werden und zum anderen können die Daten per Reflection-API gesetzt werden.
Aus meiner Sicht ist der zweite Weg, der Weg über die Reflection-API zu bevorzugen. Damit wird keine Funktionalität für das Bereitstellen der Testdaten genutzt und ungetestet eingesetzt.
Damit sind alle Vorraussetzungen erfüllt um die Testfälle zu implementieren.
Innerhalb der Testfälle kann mit Hilfe der Klasse org.junit.Assert detailliert getestet werden welche Bedingungen erfüllt sein müssen, damit der Test erfolgreich verläuft. Dabei sollten Extremwerttests nicht vernachlässigt werden, da diese durchaus Fehler in der Implementierung aufdecken können.
Die Ausführung des Tests kann einfach durch einen Rechtsklick auf die Methode und das Wählen des "Run As" Commands durchgeführt werden.
Auf der Konsole sind dann zum einen die Meldungen zu sehen, die in der Implementierung ausgegeben worden sind und zum anderen die optische Bestätigung, dass die Tests positiv verlaufen sind.
Damit können die einfachen Testfälle bereits abgedeckt werden. JUnit stellt aber auch Werkzeuge für die Überprüfung von aufgetretenen Exceptions bereit. Diese können mit Hilfe des Attributes expected in der Annotation @org.junit angegeben werden.
Tritt diese Exception während der Ausführung des Tests nicht auf, so gilt der Test automatisch als fehlgeschlagen.
Ich hoffe, ich konnte mit dieser kleinen Einführung das Interesse an JUnit wecken.
Der Quellcode kann als Eclipse-Projekt bei Mediafire heruntergeladen werden.
Das Testen von geschriebenem Code dient der Qualitätssicherung des gesamten Projektes. Dabei existieren unterschiedliche Metriken, wie viel und vor allem was in welchem Umfang getestet werden soll.
In der Regel sollten die Tests geschrieben werden bevor das eigentliche Modul entwickelt wird. Damit ist eine gründliche Auseinandersetzung mit den Anforderungen gegeben und der Entwickler gerät nicht in Versuchung nur den meist genutzten Pfad durch die Applikation zu testen.
Für das Beispiel wird ein Modul erstellt, welches eine kleine Benutzeranmeldung simuliert. Der Einfachheit halber werden die Daten im ersten Schritt nur lokal zur Verfügung stehen und werden mit Beenden des Programmes wieder gelöscht. Der Logout nach der Durchführung der unterschiedlichen Aktionen wird ebenfalls automatisiert durchgeführt.
Somit ergeben sich insgesamt 4 unterschiedliche Pfade, die getestet werden müssen.
- Login - Login [Login failure]
- Login - List all user - Logout
- Login - Create user - Create user[Conflict]
- Login - Create user - Logout
Mit diesen Informationen können alle Testfälle bereits implementiert werden.
Installation von JUnit
Die Installation von JUnit gestaltet sich sehr einfach. Es gibt zwei unterschiedliche Wege zur erfolgreichen Installation:
- Einbinden als bereits vordefinierte Bibliothek aus Eclipse
- Einbinden als externe Referenz auf das entsprechende JAR-File
Die aktuelle Bibliothek (zum Zeitpunkt dieses Artikels Versioon 4.8.2) kann über die JUnit Webseite bezogen werden. Diese wird unter Eclipse dem Projekt hinzugefügt und in den Classpath eingebunden
Nach diesem Schritt stehen alle erforderlichen Klassen zur Verfügung und der Test kann implementiert werden.
Implementierung des Tests
Für die Implementierung wird folgender Workspace aufgesetzt.
Die Implementierung des Interfaces entspricht dem UML Diagramm weiter oben. Damit können die entsprechenden Testmethoden implementiert und somit die Bedingungen für die konkrete Implementierung des User-Managers festgelegt werden.
Für die Implementierung des Testfalls wird eine neue Klasse angelegt.
Die einzelnen Methoden testen die Funktionalität des UserMgr. Zusätzlich werden Methoden für Aufgaben vor jedem Test und nach jedem Test definiert.
Mit Hilfe der Annotationen kann der Test leicht konfiguriert werden. Die Annotation org.junit.Before definiert eine Methode, die vor jedem Test ausgeführt wird. Mit org.junit.After wird eine Methode definiert, die nach der Durchführung eines jeden Tests ausgeführt werden kann.
Zusätzlich könnte der Test noch mit den Annotationen org.junit.BeforeClass und org.junit.AfterClass erweitert werden. Diese Annotationen können an statischen Methoden definiert werden und erlauben es die Methoden als statische Methoden beim Laden der Klasse und als letzte Aktion nach Testende auszuführen.
Die einzelnen Methoden des Tests werden mit org.junit.Test gekennzeichnet. Diese Annotation kann sowohl auf Klassenebene, als auch auf Methodeneben genutzt werden. Wird die Methode auf Klassenebene genutzt, dann wird jede Methode als Testmethode angesehen. Auf Methodenebene kann deutlich detaillierter gesteuert werden, welche Methode als Testmethode genutzt wird.
Das Exceptionhandling kann ebenfalls getestet werden. Dafür kann der Annotation org.junit.Test ein weiteres Attribut in Form der erwarteten Exception mitgegeben werden. Der Test wird fehlschlagen, sobald diese Exception nicht auftritt und nur dann erfolgreich sein, wenn die Exception auftritt.
Um erstellten Code effizient zu testen, wird der Entwickler immer Wissen aus der Implementierung mit einbringen und sogenannte Whitebox-Tests durchführen. Daher ist es sinnvoll an dieser Stelle die Implementierung der Klasse durchzuführen. Diese wird für das Beispiel bewusst einfach gehalten.
Für die Verwaltung der Nutzer werden zwei private Variablen deklariert, welche nach außen hin nicht sichtbar sein sollen. Daher erfolgt der Zugriff nicht über Getter- / Setter-Methoden.
Die eigentliche Implementierung stellt nun die Möglichkeit bereit einen Nutzer in die Liste der registrierten Nutzer aufzunehmen, sich einzuloggen und die Liste der eingeloggten Nutzer auszulesen.
Nach der Implementierung des Grundgerüstes werden die Testmethoden konkret implementiert. Um die Testmethoden effizient und sinnvoll zu implementieren ist ein wenig Wissen über die eigentliche Implementierung notwendig. Die Daten über die angemeldeten und verfügbaren Nutzer werden intern in einer Map verwaltet. Der Einfachheit halber werden die Daten im Klartext abgelegt. Um sinnvoll testen zu können müssen aber vor einem Test bereits Daten in dieser Map vorhanden sein.
Diese Daten können auf unterschiedliche Wege in die Map eingefügt werden. Zum einen können die Funktionen des Managers genutzt werden und zum anderen können die Daten per Reflection-API gesetzt werden.
Aus meiner Sicht ist der zweite Weg, der Weg über die Reflection-API zu bevorzugen. Damit wird keine Funktionalität für das Bereitstellen der Testdaten genutzt und ungetestet eingesetzt.
Innerhalb der Testfälle kann mit Hilfe der Klasse org.junit.Assert detailliert getestet werden welche Bedingungen erfüllt sein müssen, damit der Test erfolgreich verläuft. Dabei sollten Extremwerttests nicht vernachlässigt werden, da diese durchaus Fehler in der Implementierung aufdecken können.
Die Ausführung des Tests kann einfach durch einen Rechtsklick auf die Methode und das Wählen des "Run As" Commands durchgeführt werden.
Auf der Konsole sind dann zum einen die Meldungen zu sehen, die in der Implementierung ausgegeben worden sind und zum anderen die optische Bestätigung, dass die Tests positiv verlaufen sind.
Damit können die einfachen Testfälle bereits abgedeckt werden. JUnit stellt aber auch Werkzeuge für die Überprüfung von aufgetretenen Exceptions bereit. Diese können mit Hilfe des Attributes expected in der Annotation @org.junit angegeben werden.
Tritt diese Exception während der Ausführung des Tests nicht auf, so gilt der Test automatisch als fehlgeschlagen.
Ich hoffe, ich konnte mit dieser kleinen Einführung das Interesse an JUnit wecken.
Der Quellcode kann als Eclipse-Projekt bei Mediafire heruntergeladen werden.
Abonnieren
Posts (Atom)